
La IA conoce los negocios. No conoce el tuyo.
Por qué la ventaja competitiva de la IA en las empresas no está en el LLM, sino en un modelo de tu propio negocio que aprende de cada período que cierras.
La ventaja no es el LLM
Por qué la ventaja competitiva de la IA en las empresas no está en el LLM, sino en el modelo de tu propio negocio.
Hagamos un experimento.
Abre cualquier modelo de frontera y pregúntale:
¿Qué debería hacer una empresa si un proveedor crítico deja de entregar durante seis semanas?
La respuesta va a ser buena. Va a hablar de proveedores alternativos, de priorizar clientes según su rentabilidad, de reasignar inventario entre centros de distribución, de renegociar condiciones, de comparar el costo del flete aéreo con el costo de un quiebre de stock. Va a estar bien escrita y va a ser completamente razonable.
Ahora hagamos la pregunta que de verdad nos importa:
¿Qué deberíamos hacer si el Proveedor X (nuestro proveedor crítico) deja de entregar durante seis semanas, y qué pasa en ese escenario con el inventario, el nivel de servicio, el margen y la caja?
Aquí empieza el problema, y no es el que uno esperaría. El LLM no se va a negar a responder. Va a contestar con la misma fluidez, va a proponer un curso de acción y, si le pedimos números, nos va a dar números.
El problema es que ni él ni nosotros tenemos forma de saber si esos números son ciertos.
Porque el modelo no conoce nuestros costos reales, nuestras restricciones de capacidad, nuestros lead times, nuestras políticas de asignación, cómo se comportan nuestros clientes ni, sobre todo, la forma específica en que todas esas variables se afectan entre sí. Sabe muchísimo sobre empresas. No sabe cómo funciona esta.
El contexto no alcanza
La respuesta instintiva es darle mejor información: conectarlo al ERP, al data lake, a los procedimientos, a los contratos, a los reportes de gestión.
Eso es útil, y vale la pena hacerlo. Pero confunde dos cosas distintas.
Tener acceso a información sobre una empresa no es lo mismo que entender su mecánica. Conocer el stock de hoy, los costos del último cierre y la demanda del mes pasado no permite responder qué pasaría si mañana cambiáramos una decisión. Para eso hay que representar las relaciones entre esas variables, no solo sus valores.
Si cambia la demanda, cambia el inventario. Si cambia el inventario, cambia la reposición. Si cambia el plan de producción, cambian la utilización de capacidad, los requerimientos de materiales y los costos. Y todo eso termina moviendo las ventas, el margen, el capital de trabajo y el flujo de caja.
Los datos responden qué es. Un modelo responde qué pasaría si.
Y aquí viene la parte incómoda, que es décadas anterior a la IA.
El conocimiento existe, pero no vive en ningún lado
El obstáculo no es solo que el LLM no conozca el negocio. Es que, en la mayoría de las organizaciones, nadie tiene ese conocimiento formalizado de manera integrada.
Una parte vive en la experiencia de los gerentes. Otra parte vive en planillas construidas y emparchadas durante años, cuya lógica entiende una sola persona. Otra está repartida entre el ERP, la herramienta de forecasting, el modelo financiero y las aplicaciones propias de cada área.
Cada pieza tiene un fragmento de la lógica del negocio. Supply Chain conoce las restricciones de abastecimiento. Operaciones sabe cuál es la capacidad real, que no es la capacidad nominal. Ventas entiende cómo reaccionan los clientes ante un cambio de precio. Finanzas sabe cómo todo eso termina impactando en el capital de trabajo y en la caja.
Pero las conexiones entre esas piezas, que es exactamente donde se toman las decisiones importantes, existen sobre todo en la cabeza de las personas que se sientan en la misma reunión. No hay un único lugar donde se pueda leer «así funciona nuestro negocio». Mucho menos un mecanismo que actualice esa representación a medida que la organización aprende.
Incluso el flujo de información entre esas piezas está sin resolver: exportar, pegar en una planilla, copiar supuestos, conciliar versiones, esperar a que cierre otro proceso.
Así, la empresa genera experiencia todos los días y no tiene forma de convertirla en conocimiento que se acumule. Cada ciclo de planificación empieza reconstruyendo a mano una visión integrada, una visión que se evapora en el momento en que termina la reunión.
Antes de pedirle a la IA que entienda nuestro negocio, hay que resolver eso.
Un modelo computable del negocio
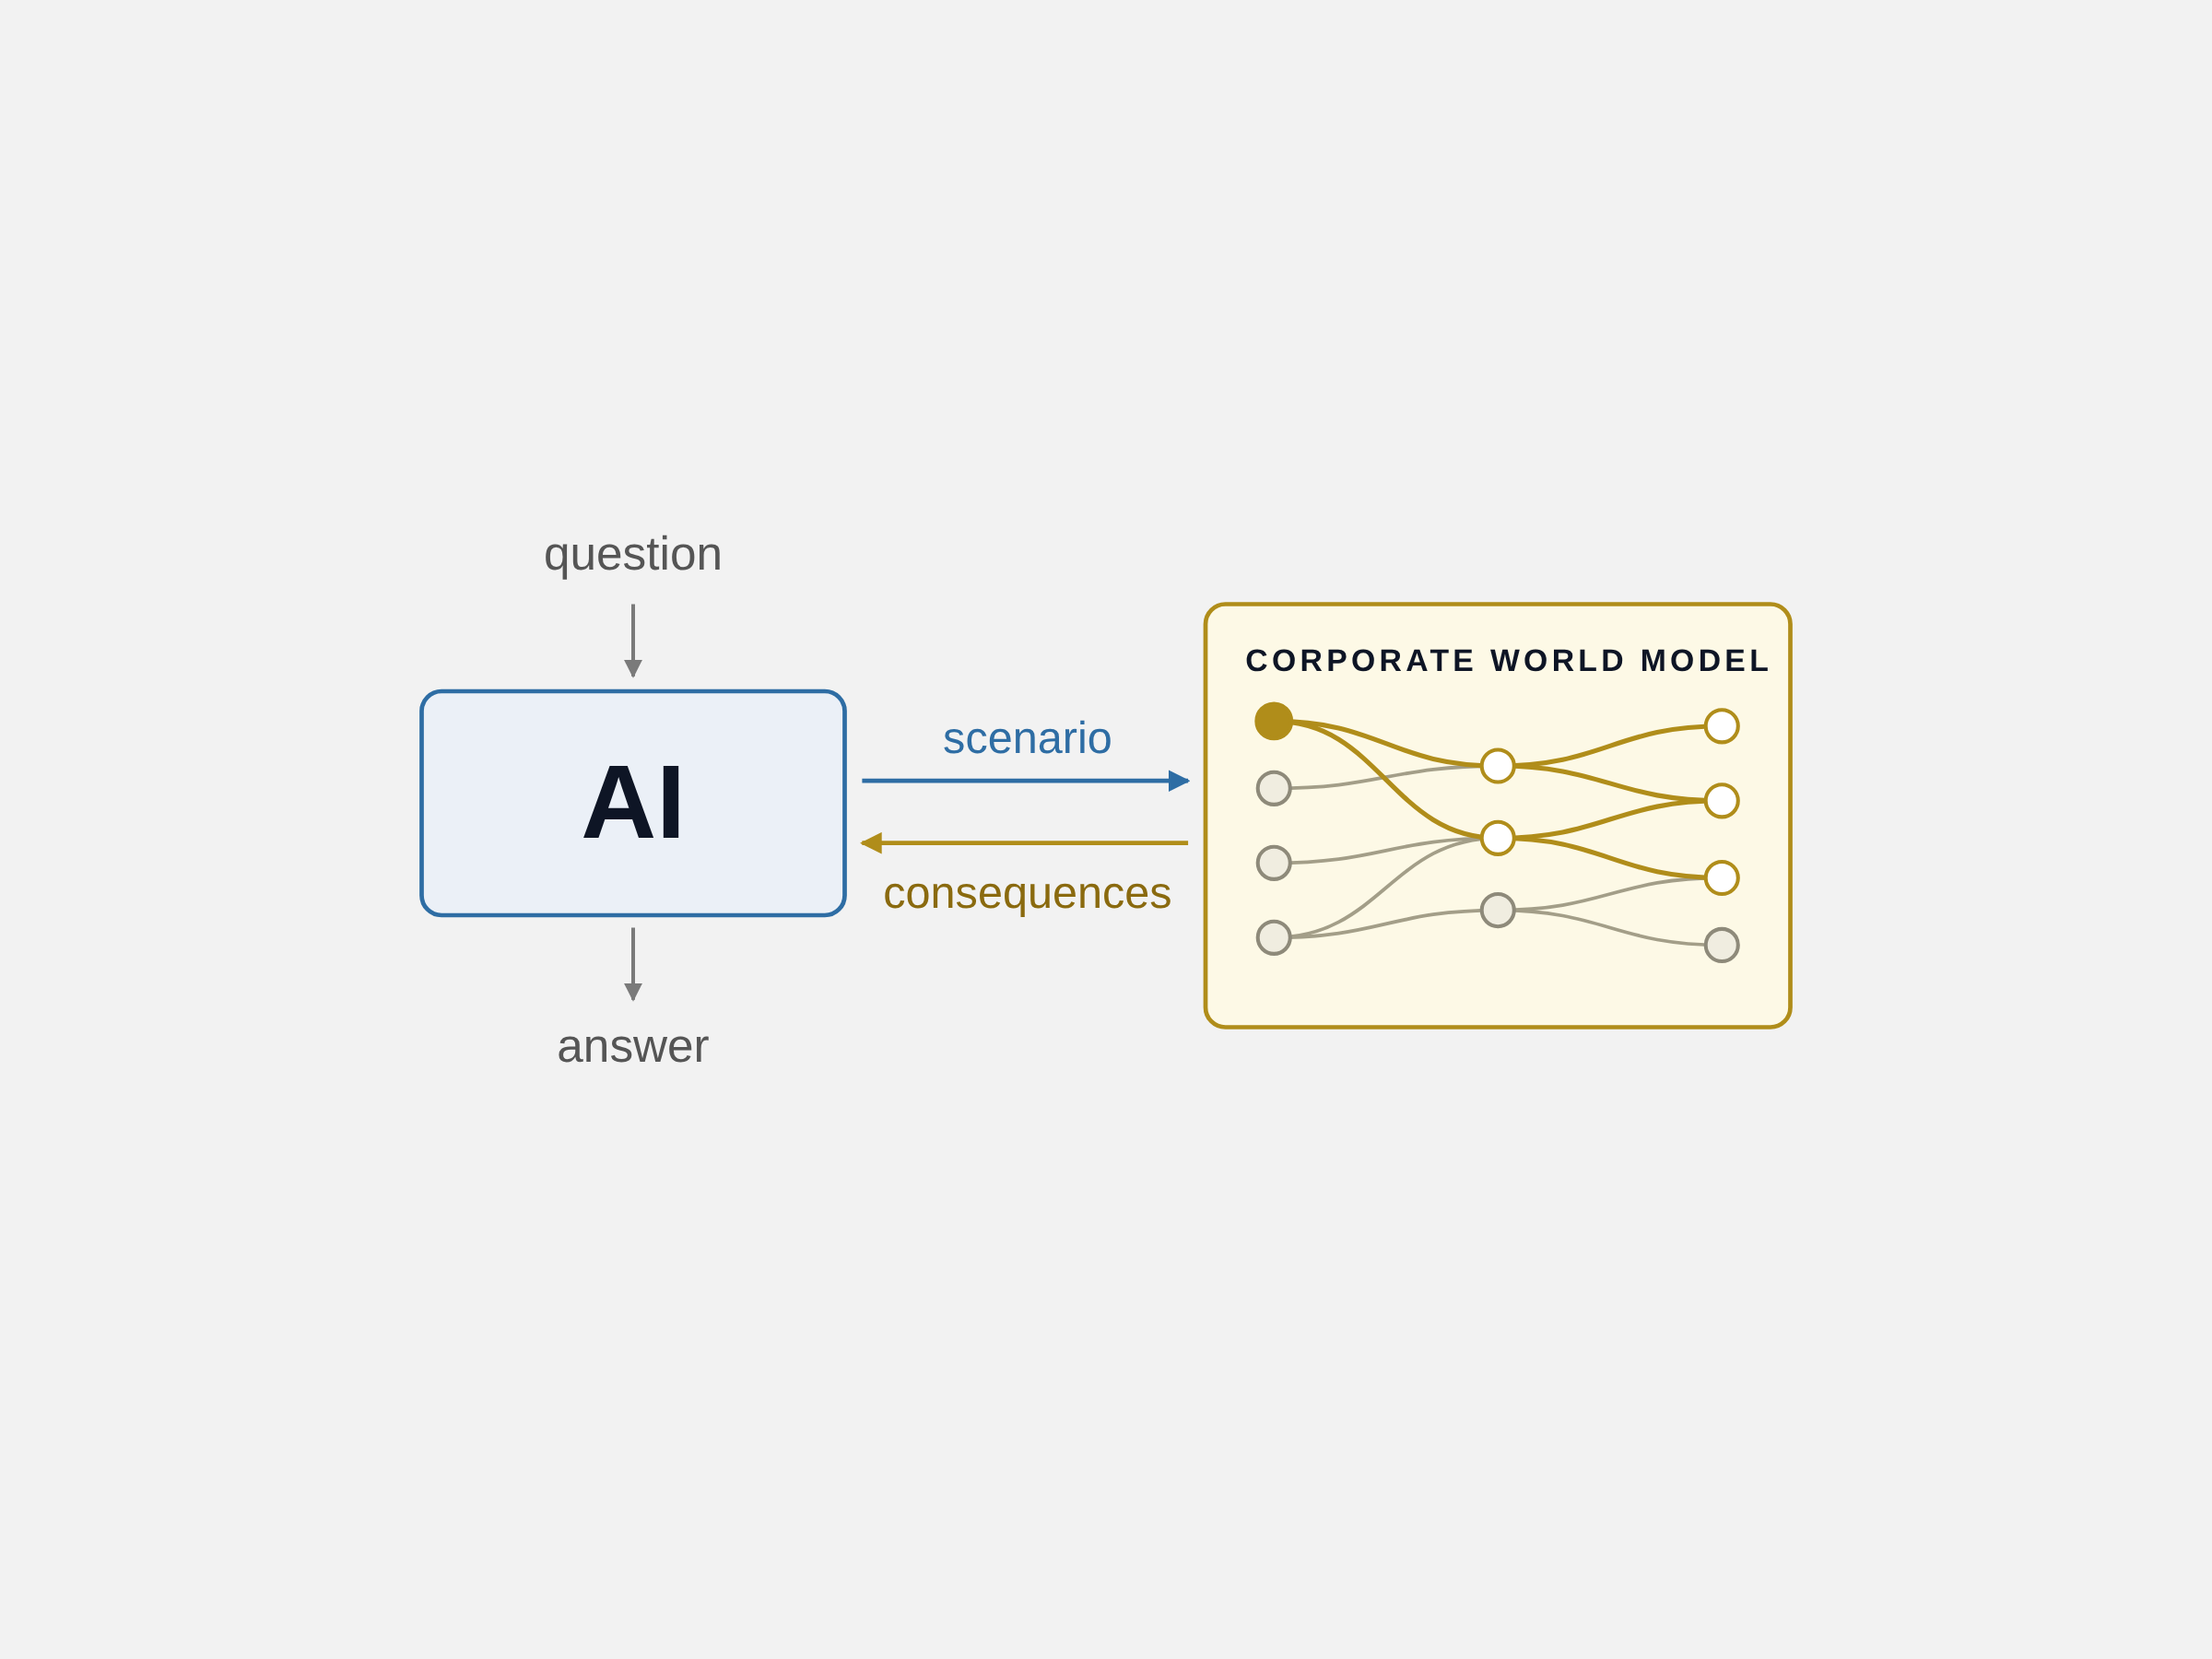
Hay un concepto de la investigación en IA que es cada vez más relevante aquí: el world model, una representación interna de un entorno que permite anticipar cómo evoluciona ese entorno ante distintas acciones, en lugar de responder solo a partir de patrones aprendidos.
En una organización, ese mundo es el propio negocio. Lo que hace falta, entonces, es un Corporate World Model: una representación ejecutable de cómo funciona económicamente una empresa.
En su alcance completo, por ejemplo en un proceso de Integrated Business Planning, encadena demanda, inventario, abastecimiento, producción, costos, inversiones, ventas, capital de trabajo, flujo de caja y estados financieros dentro de un único sistema.
Lo que lo separa de un dashboard o de un data warehouse no es la cobertura de datos, sino la naturaleza del objeto. Un dashboard muestra el estado del negocio. Un Corporate World Model contiene las reglas, las restricciones, las relaciones matemáticas y las dependencias que hacen que una decisión tomada en un extremo de la organización se propague hasta el otro.
Eso permite un cambio de verbo: se pasa de observar el negocio a experimentar con él.
¿Qué pasa si la demanda crece un 15%? ¿Qué nivel de inventario maximiza el servicio sin comerse el capital de trabajo? ¿Qué combinación de producción, compras y asignación protege mejor el margen? ¿Qué le hace a la caja adelantar esta inversión?
El término viene de la investigación en IA, pero la pregunta que responde es la más antigua de la gestión: si hago esto, ¿qué pasa después?
¿Y cómo sabemos que el modelo es correcto?
Este es el paso que suele saltearse.
Construir un modelo del negocio no garantiza que el modelo sea fiel. Toda representación simplifica. Hay parámetros mal calibrados, restricciones que nadie documentó, comportamientos que se resisten a ser formalizados y efectos que solo aparecen bajo ciertas condiciones.
Un LLM sobre un modelo equivocado no produce mejores decisiones. Produce decisiones equivocadas, mejor redactadas.
La buena noticia es que la evidencia necesaria para corregirlo ya existe, y la organización la genera todos los meses. Solo que la usa mal.
Pensemos en la revisión mensual de desvíos. La demanda no fue la esperada, el tipo de cambio se movió, el mix se corrió hacia productos de menor margen. Se revisan las causas, se ajustan los supuestos del ciclo siguiente, termina la reunión. Es un ritual razonable, pero responde una sola pregunta: ¿por qué el futuro no fue lo que imaginamos?
Hay una segunda pregunta que casi nunca se hace: ahora que sabemos exactamente qué pasó, ¿nuestro modelo del negocio podría haberlo explicado?
La primera interroga a nuestro pronóstico. La segunda interroga a nuestro entendimiento.
Dos errores dentro del mismo desvío
Tomemos un caso deliberadamente simple.
El plan del mes proyectaba 100 unidades a un precio de 10, con un costo variable unitario de 6 y costos fijos de 250. Resultado esperado: 150.
El mes cerró con 80 unidades vendidas y un resultado real de 60. Desvío total: –90.
La conversación habitual termina ahí: vendimos menos de lo planeado. Pero podemos hacer algo más. Podemos volver a correr el modelo, reemplazando el supuesto de demanda por el valor real (80 unidades) y dejando todo lo demás exactamente como ocurrió.
Alimentado de esa forma, el modelo devuelve 70.
Eso divide el desvío en dos:
- –80 es error de pronóstico. No logramos anticipar la demanda. Es un problema de información sobre el futuro, y siempre va a existir.
- –10 es error de modelo. Aun conociendo perfectamente cada variable externa, nuestra representación del negocio no logra reproducir lo que produjo la realidad. Hay algo en cómo funciona la empresa que no está en el modelo.
Ese segundo número es el interesante. Al investigarlo aparece, por ejemplo, que producir 80 en lugar de 100 dejó a la planta por debajo del nivel de utilización a partir del cual el rendimiento se degrada, y el costo variable real fue 6,125 en lugar de 6. El modelo suponía un costo unitario constante. No lo es.
Diez unidades monetarias parecen poco frente a noventa. Pero la asimetría entre los dos errores es el centro del argumento:
El error de pronóstico es aleatorio y muere con el período. El error de modelo es sistemático y contamina cada decisión futura.
Ese supuesto de costo constante no falló solo este mes. Está sesgando en silencio cada escenario de bajo volumen que evalúa el modelo: el análisis de una promoción, la decisión de aceptar un pedido marginal, la evaluación de discontinuar una línea, el cálculo del punto de equilibrio. Cada respuesta que el modelo dio y va a dar en esa zona está equivocada en la misma dirección.
Mejorar el pronóstico mejora un plan. Mejorar el modelo mejora, potencialmente, cada decisión que se tome sobre ese negocio.
El ciclo de aprendizaje
La forma de convertir esto en un proceso es un ciclo de aprendizaje: un ciclo en el que el modelo no solo produce planes, sino que se corrige contra lo que devuelve la realidad.
Su paso central es volver a correr un período cerrado dentro del modelo, reemplazando cada supuesto por el valor que realmente ocurrió: la demanda real, los precios reales, los tipos de cambio reales, los lead times reales, los costos reales y, esto es esencial, las decisiones que realmente se tomaron, no las que proponía el plan.
Después se compara lo que el modelo dice que debería haber pasado con lo que pasó.
Si coinciden, el modelo representa razonablemente bien esa parte del negocio y el desvío fue solo un problema de pronóstico. Si no coinciden, encontramos algo más valioso que un desvío presupuestario: encontramos una zona del negocio que todavía no entendemos.
Cada brecha del re-run es una hipótesis en espera. Tal vez la elasticidad precio no es la que suponíamos. Tal vez ese lead time depende de una variable que ignoramos. Tal vez una restricción de producción se comporta distinto por encima de cierto nivel de utilización. Tal vez una política comercial produce un efecto de segundo orden que el modelo nunca contempló.
El ciclo completo se ve así:
Modelar → Planificar → Decidir → Ejecutar → Observar → Volver a correr → Comparar → Aprender → Mejorar
La planificación deja de ser solo un instrumento para anticipar el futuro. Se convierte en un mecanismo sistemático para entender mejor el negocio.
Hay un requisito operativo que vale la pena decir en voz alta, porque es el que suele fallar: el ciclo de aprendizaje exige registrar decisiones, no solo resultados. Si el sistema guarda que se vendieron 80 unidades pero no que el inventario se reasignó entre dos centros de distribución en la semana 3, el re-run va a comparar contra una historia que nunca ocurrió. Buena parte del trabajo inicial en esta disciplina consiste, simplemente, en empezar a dejar rastro.
Ahora sí, dónde entra el LLM
Con esta arquitectura, el rol del modelo de lenguaje cambia de forma bastante limpia.
Deja de ser el lugar donde esperamos que vivan todas las respuestas. Se convierte en la interfaz que interpreta la pregunta, formula la hipótesis, dispara el cálculo, compara escenarios y explica el resultado en términos de negocio.
El LLM entiende la pregunta. El Corporate World Model simula las consecuencias.
Volvamos al proveedor que deja de entregar durante seis semanas: la pregunta se hace en lenguaje natural, pero la respuesta ya no sale de lo que el modelo leyó sobre supply chain en general. Sale de correr esa disrupción contra una representación de nuestra propia operación, con nuestras capacidades, nuestros contratos y nuestro mix.
Pero hay un segundo rol, menos obvio e igual de interesante: el LLM puede leer los residuos del re-run.
Una brecha del modelo es, en bruto, una tabla de diferencias entre lo calculado y lo ocurrido, abierta por producto, planta, período y línea del estado de resultados. Interpretar ese patrón (descartar el ruido, notar que las diferencias se concentran en los meses de baja utilización, conjeturar que el costo unitario no es constante) es exactamente el tipo de razonamiento inductivo sobre datos estructurados en el que estos sistemas son buenos.
Ahí es donde el ciclo se cierra de verdad: el modelo produce predicciones, la realidad produce evidencia, el LLM propone revisiones estructurales y el equipo decide cuáles adoptar. La decisión sigue siendo humana, pero detectar y conjeturar dejan de depender de que alguien tenga tiempo para mirar.
Lo que va a preguntar un lector escéptico
«Ya tenemos un modelo: la planilla.» Cierto, y ese es precisamente el punto. La planilla ya es un modelo del negocio; lo que le falta es trazabilidad, integración entre áreas, la capacidad de correr escenarios en serie y cualquier memoria de sus propios errores. La diferencia no es tener un modelo o no tenerlo. Es tener uno que aprende.
«Esto es sobreajustar el modelo al ruido.» Sí, si se corrige la estructura después de cada brecha de un solo período. El criterio tiene que ser el opuesto al del análisis de desvíos tradicional: una brecha aislada se ignora; una brecha que se repite con el mismo signo bajo las mismas condiciones es una señal. Los re-runs se leen en serie, no de a uno.
«Hay cosas que no se pueden modelar.» También es cierto. La jugada de un competidor, una decisión regulatoria, cómo reacciona una cuenta clave ante un cambio de ejecutivo de cuenta. El objetivo no es un modelo completo del mundo, sino uno que explique la parte estructural del negocio y que sea explícito sobre dónde termina.
Vale la pena agregar que nada de esto es un invento reciente. Los ingenieros de control lo llaman identificación de sistemas, y los gemelos digitales industriales funcionan así desde hace años. Lo nuevo es aplicarlo a la capa económica de la empresa (no a una máquina, sino a todo el negocio) y acoplarlo a una interfaz capaz de conversar sobre los resultados.
El activo que se capitaliza
Los LLM van a seguir mejorando y van a ser cada vez más accesibles. Justamente por eso van a diferenciar cada vez menos. Si un competidor puede licenciar mañana el mismo modelo, el modelo no es una ventaja.
Lo que no se puede comprar ni replicar en un trimestre es una representación computable de cómo funciona una empresa específica, corregida contra la realidad ciclo tras ciclo durante años. Cada período genera evidencia. Cada brecha revela algo que no entendíamos. Cada vuelta del ciclo mejora la representación. Y cada mejora se propaga a todas las decisiones futuras.
Es un tipo de activo poco habitual: uno que acumula valor con el uso.
Volvamos al principio. La IA conoce los negocios y no conoce el tuyo, y un modelo más grande no va a resolver eso: los LLM que vienen van a saber todavía más sobre las empresas en general, y exactamente lo mismo sobre la tuya.
Lo que sí lo resuelve es acoplarlos a un modelo de tu negocio que aprenda de la realidad ciclo tras ciclo. Esa combinación no se compra. Se construye, y lleva tiempo.
Por eso la pregunta no es qué LLM vas a usar el año que viene. Es cuántos ciclos de aprendizaje va a tener tu modelo para entonces.
También te podría interesar
IA "agentic" en planning: separar el anuncio del producto
La volatilidad arancelaria de 2026 exige replanificar en días, no en meses. Qué capacidades necesitan Supply Chain y Finanzas para no quedar expuestas.
Gobernanza de datos para planificar con confianza
Control, trazabilidad y consistencia en cada número
Modelar el negocio, no solo los números
Cómo los diagramas de influencia de Pyplan transforman reglas complejas en decisiones claras
Descubre Pyplan en acción
pondremos en contacto contigo!